在開源生成式 AI 的快速演進下,基於 MiniMax-H3 架構深度改造的「P-H3-Image」圖像生成與編輯模型近期正式登陸 ComfyUI。這套由 Pruna AI 釋出的方案,主打僅需極短的 8 步採樣(8 steps)、無需 CFG 導引與負向提示詞,就能原生輸出高達 800 萬像素(8 MP)的細緻圖像。更令人驚豔的是其多圖融合與強大的圖像編輯(Image Edit)能力,官方內建了基於 Qwen3.5-9B 的 Prompt Upsampler,能將簡短的修改要求自動擴寫為模型最容易理解的結構化指令。對於過去曾下載過原生 MiniMax H3 基礎模型(如 minimax_h3_fl2va_pruned_fp8_scaled.safetensors)的創作者而言,本次完全不需要重複下載近 20 GB 的龐大主模型,僅需額外下載約 1.8 GB 的專用 LoRA 以及對應的 VAE 與文字編碼器,即可省時省流地無縫接入最新工作流。
在實際硬體運算表現方面,本次實測採用 NVIDIA GeForce RTX 5070 Ti 16GB VRAM 搭配 64GB 系統記憶體的硬體環境。雖然 33.1B 參數量的模型在完整運算時峰值顯存會超出 16GB 門檻,但藉由系統記憶體共享與動態卸載機制,在自訂的 1920 × 1920 px 解析度下,單張圖片的生成時間穩定落在 1 分鐘左右,整體流暢度令人滿意。本篇測試特別以本站四位原創看板娘「萌芽娘」、「萌樂」、「方塊鴨娘」與「優曇華」的透明背景全身站姿立繪作為基準來源(Picture 1),透過圖像編輯工作流下達「改為雙手比勝利姿勢盤腿坐、背景置於櫻花樹下與落櫻紛飛」的全新指令,實測在面部特徵、髮型與服裝細節完全鎖定的前提下,進行全身肢體大改與背景全重繪的驚人轉換效果!
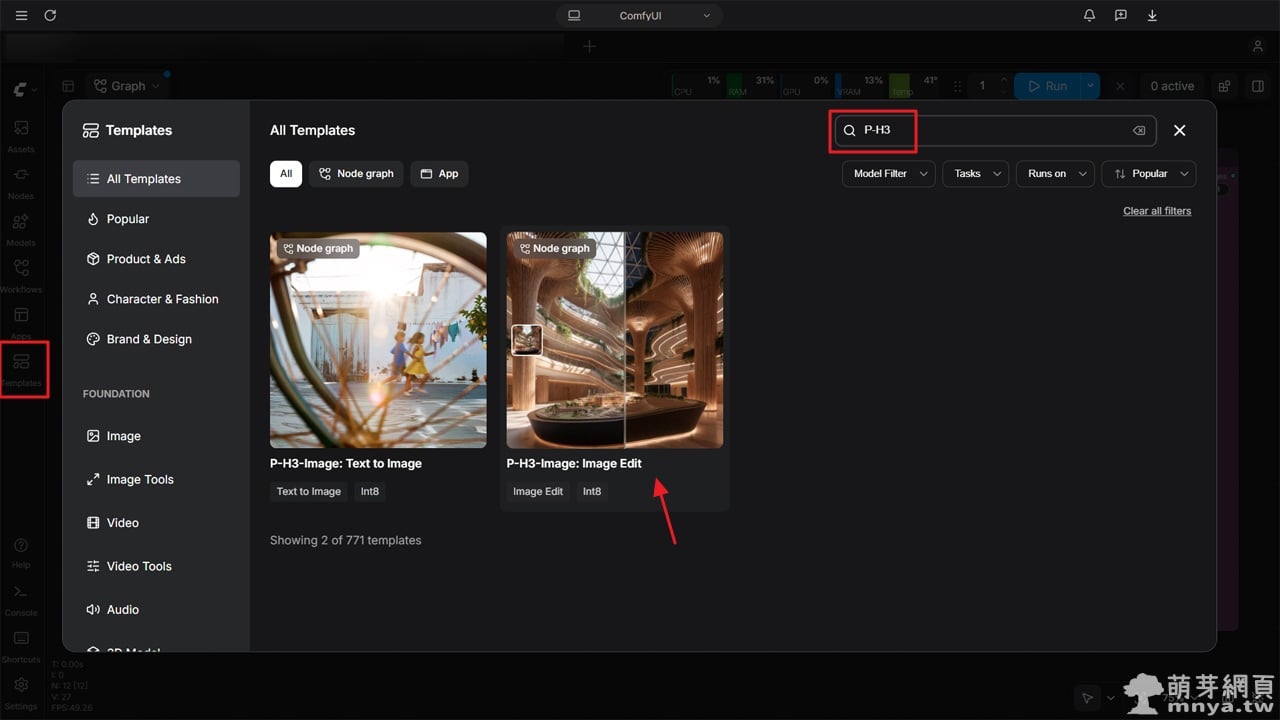
▲ 開啟 ComfyUI 的範本庫(Templates)後,於右上角搜尋「P-H3」,即可快速找到官方內建的原生工作流「P-H3-Image: Image Edit」,點擊即可一鍵將完整節點圖載入至畫布中。
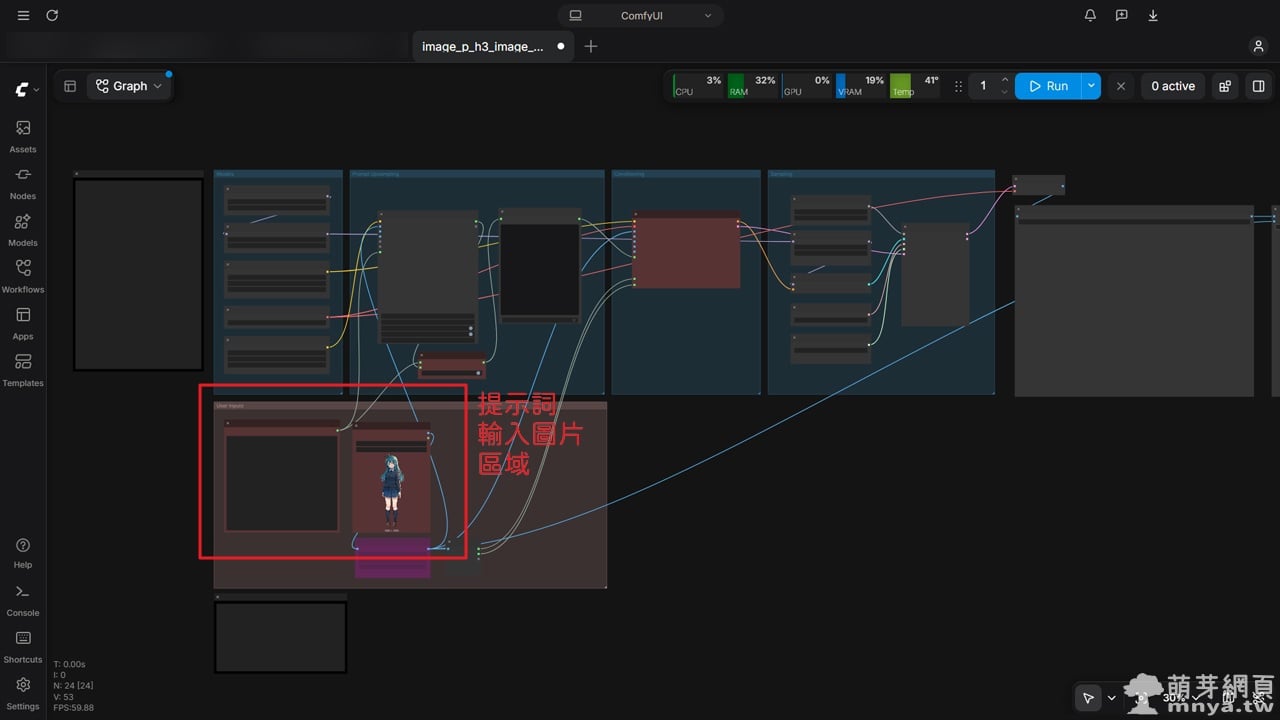
▲ 載入工作流後的完整全景圖,我已經完全所有模型的下載與載入(用過 MiniMax H3 基礎模型的人不用再重新下載主模型喔!)。在左下方的「User Inputs」群組區塊中,已清楚規劃好提示詞輸入框與來源圖片載入節點,創作者只需在此處集中操作即可完成所有設定。
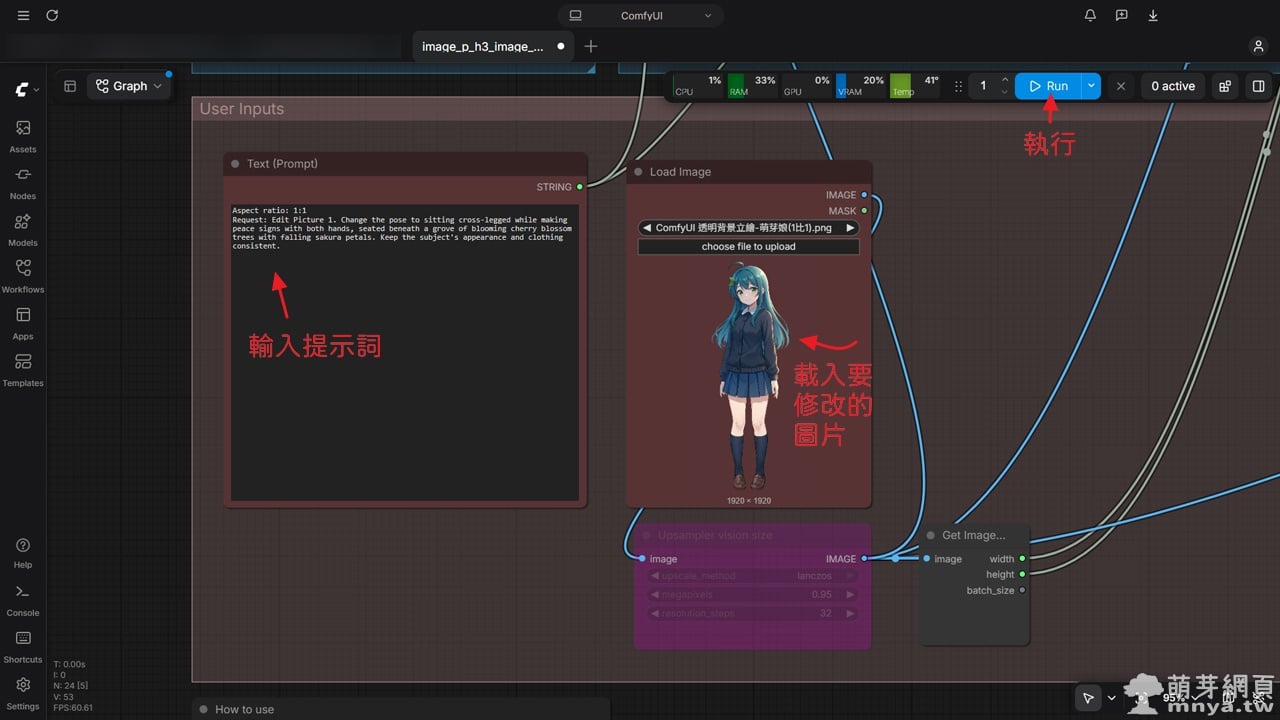
▲ 在使用者輸入區載入萌芽娘的透明背景站姿立繪,並於左側填入比例規格與修改提示詞(留在下方供參考),點擊右上角的「Run」按鈕即可交由內建擴寫模型展開指令並開始進行 8 步採樣生成。
Aspect ratio: 1:1
Request: Edit Picture 1. Change the pose to sitting cross-legged while making peace signs with both hands, seated beneath a grove of blooming cherry blossom trees with falling sakura petals. Keep the subject's appearance and clothing consistent.
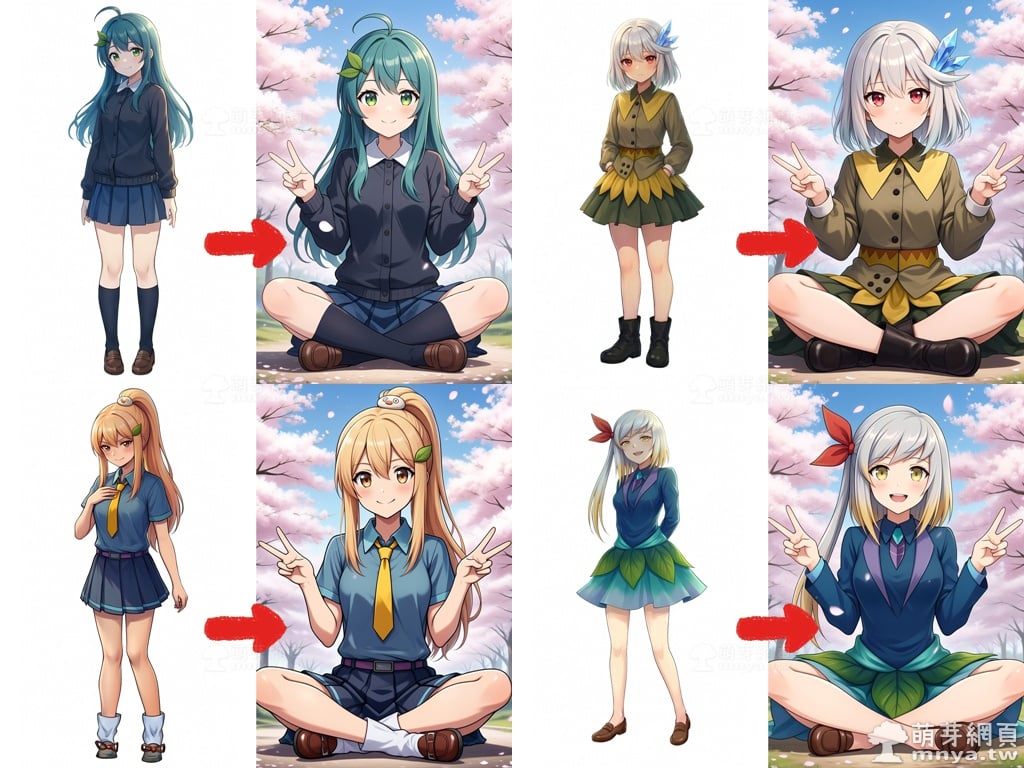
▲ 四位看板娘(萌芽娘、方塊鴨娘、萌樂、優曇華)的重繪實測對比。原有的全身站姿立繪皆精準轉為盤腿坐姿與雙手比剪刀手,在完美保留角色面貌與服裝設定的同時,順利融入盛開的櫻花樹背景,效果令人驚艷。
目前測試了單圖編輯重繪能力,那該模型是否能參考多張圖進行融合編輯重繪呢?請參考下篇專題文章!



 《上一篇》Timberland 男款灰色 Mt. Maddsen 2.0 防水健行靴 (A5SJ2EL7)
 《下一篇》ComfyUI x MiniMax H3 x P-H3-Image:維持圖1角色特徵、參考圖2服裝換裝生成實測


留言區 / Comments
萌芽論壇