在掌握了單圖的姿態與背景重繪後,P-H3-Image 另一項極具潛力的特色便是支援多張參考圖的「多圖屬性轉移與圖像融合」能力。傳統以 AI 進行角色換裝時,往往需要透過 ControlNet、IP-Adapter 搭配精細的重繪遮罩(Inpainting Mask),不僅節點接線複雜,且容易出現服裝邊緣溢出或風格不連貫的瑕疵。而 P-H3-Image 透過其強大的多圖注意力機制與內建的 Prompt Upsampler,讓創作者只需在 ComfyUI 原生工作流中多拉出一個圖片載入節點作為 Picture 2,就能用自然語言直接下達換裝與姿勢調整的指令。
本次實測直接以 ComfyUI 官方提供的「P-H3-Image: Image Edit」工作流為基底進行擴充,在工作流中新增一個獨立的「Load Image」節點,專門載入純黑色比基尼的服裝單品去背圖。測試中以本站看板娘「萌樂」的全身站姿立繪作為 Picture 1,藉由提示詞精準指示模型將服裝替換為 Picture 2 的款式,同時把站立姿態一口氣改為盤腿坐姿,並將背景替換為純白底色。在維持萌樂招牌銀白短髮、側邊藍色水晶髮飾與標誌性神韻的前提下,實測模型在面臨大跨度換裝與姿態重組時的細節保留度與生成穩定性。
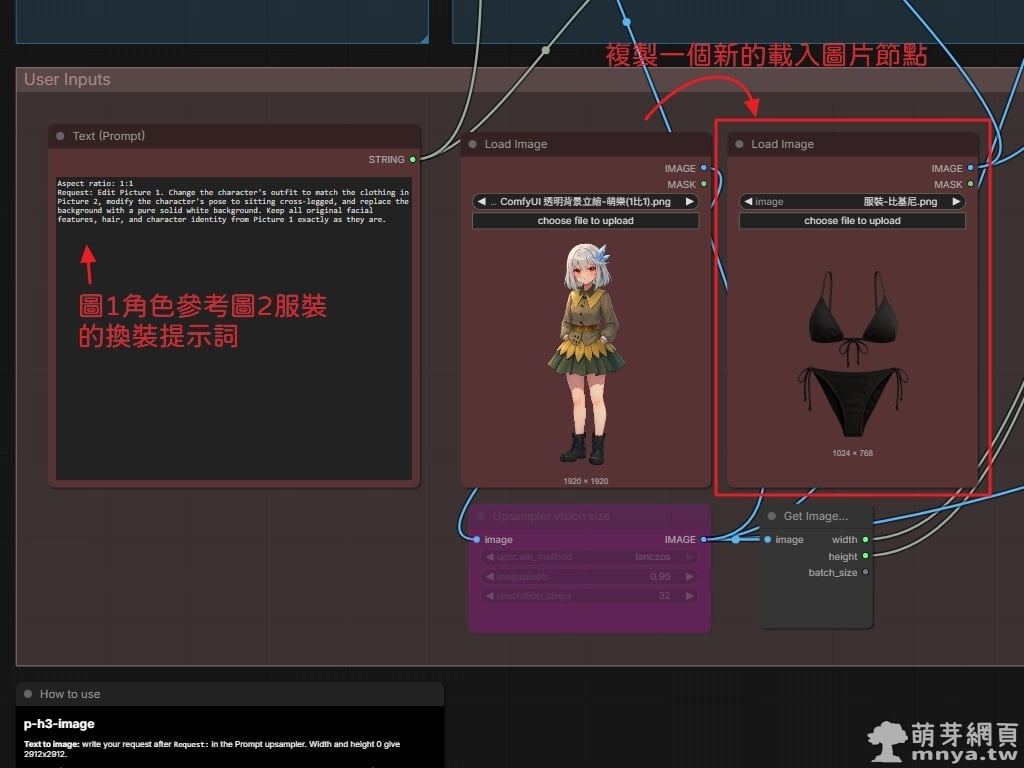
▲ 在工作流中額外複製一個「Load Image」節點作為圖 2 來源,分別載入萌樂的全身站姿立繪與黑色比基尼參考圖,並於提示詞框填入多圖編輯換裝指令:
Aspect ratio: 1:1
Request: Edit Picture 1. Change the character's outfit to match the clothing in Picture 2, modify the character's pose to sitting cross-legged, and replace the background with a pure solid white background. Keep all original facial features, hair, and character identity from Picture 1 exactly as they are.
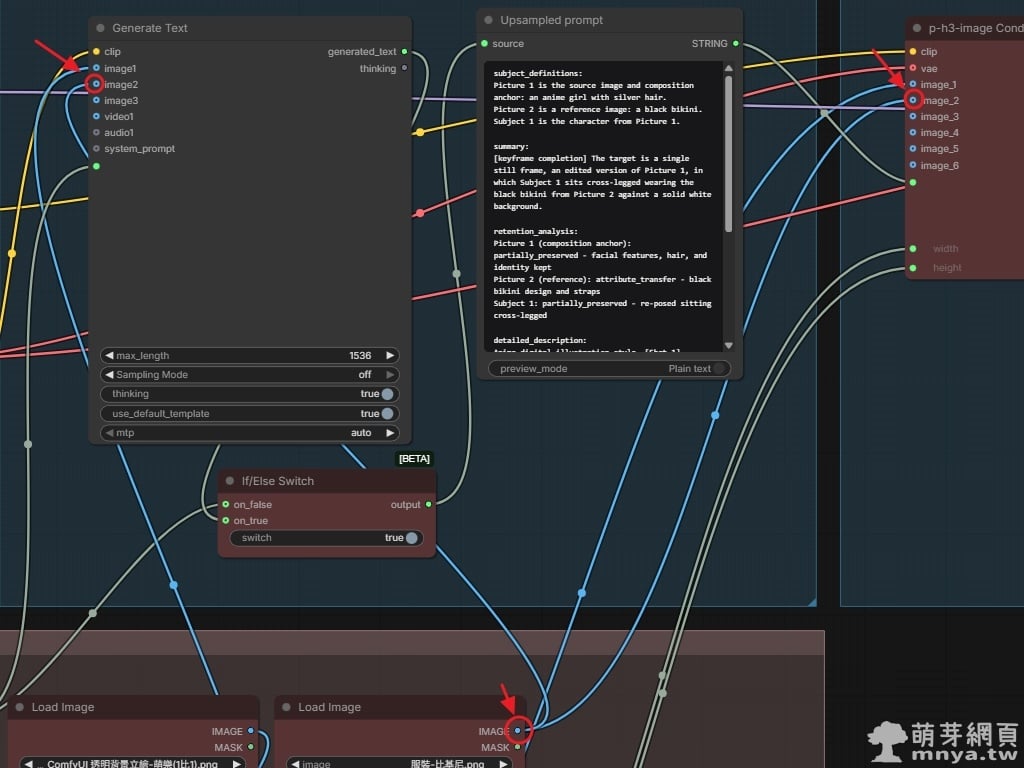
▲ 將新節點的 IMAGE 輸出同時拉線接至「Generate Text」與「p-h3-image Conditioning」的 image_2 輸入點;中央預覽框顯示內建擴寫模組已精準解析圖 1 與圖 2 的關聯。
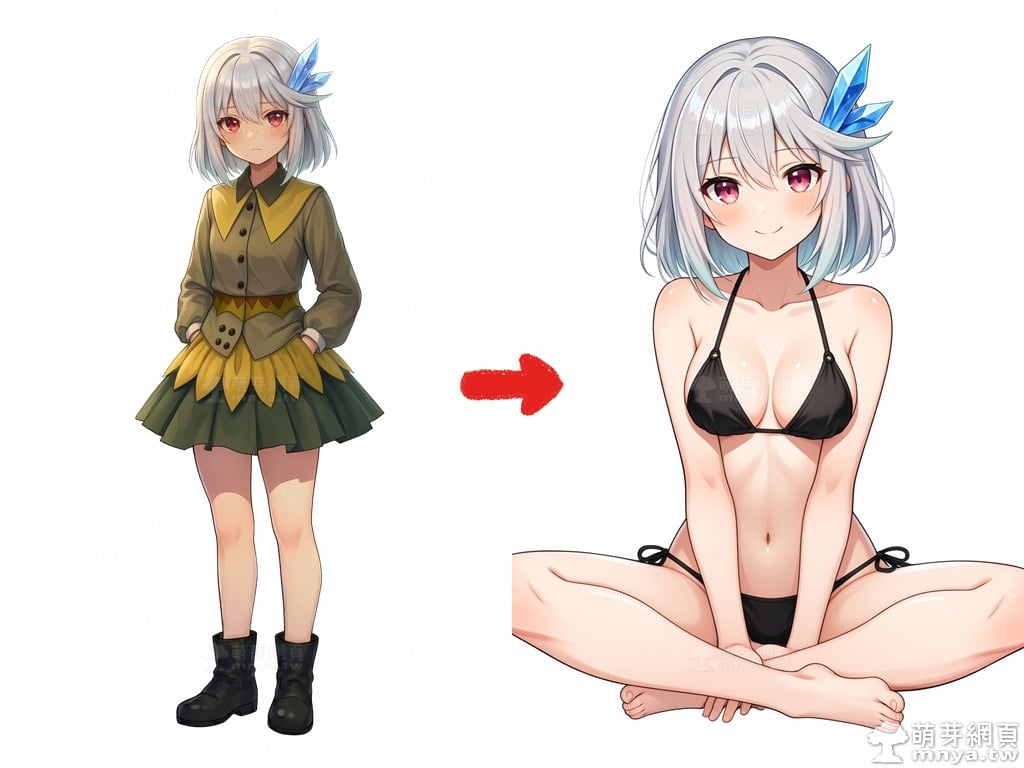
▲ 最終生成成果對比。萌樂不僅精準換上了參考圖 2 的黑色綁帶比基尼,全身姿勢也流暢轉換為盤腿坐姿,同時招牌的銀白短髮、頭部水晶飾品與臉部神態皆維持極高一致性。
為了更進階測試模型能力,在下一篇專題中,我將示範多角色丟入同一場景互動!



 《上一篇》ComfyUI x MiniMax H3 x P-H3-Image:高品質圖片重繪工作流生成實測
 《下一篇》ComfyUI x MiniMax H3 x P-H3-Image:指定背景與多位角色生成互動圖,挑戰模型多圖合成編輯能力!


留言區 / Comments
萌芽論壇